Schritt 3 von 4 · SprechenSkript und Stimme
Ein Skript mit Kapiteln – und eine Stimme dazu.
Ein Sprachmodell schreibt aus den geordneten Daten das Skript. Es bekommt nur Text und gibt nur Text zurück; Werkzeuge hat es keine. Es kann also nichts senden und nichts löschen.
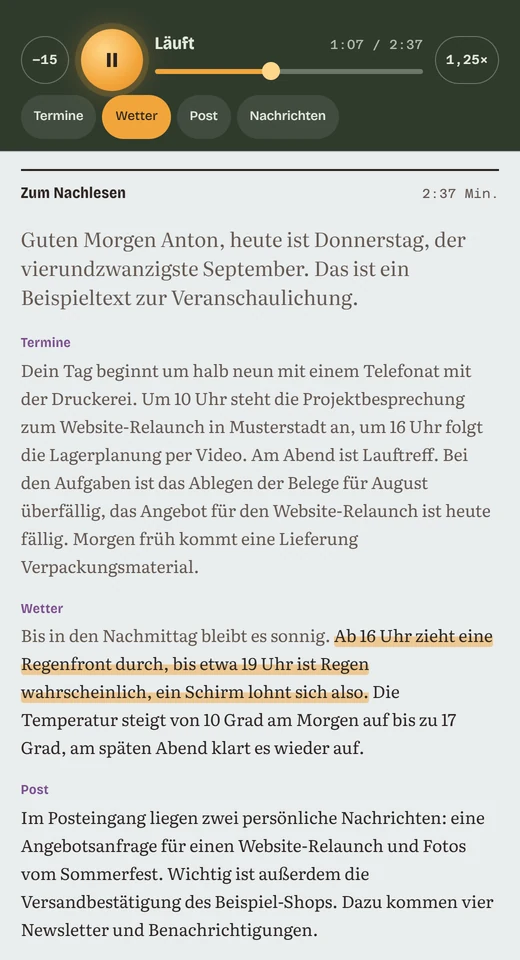
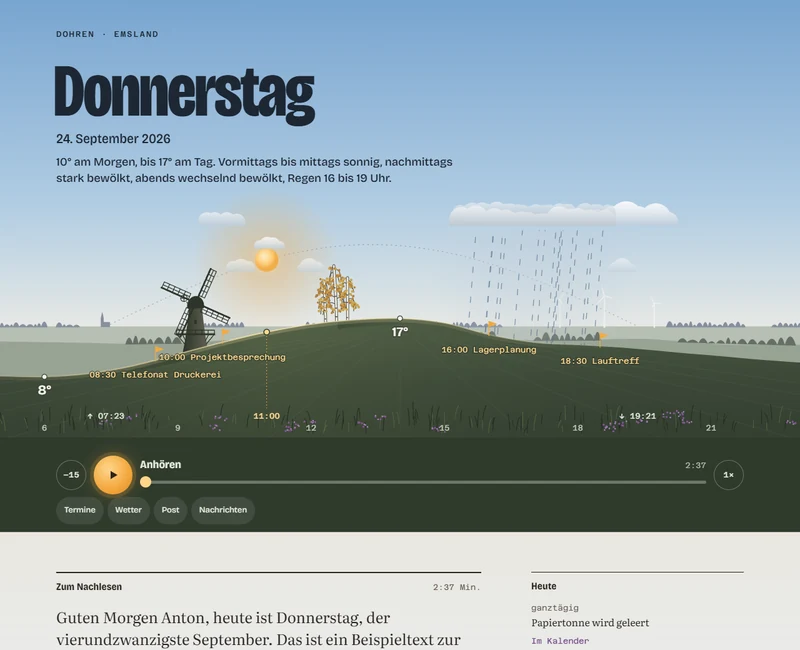
Marken wie [termine] werden zu Kapiteln. Text und Ton werden gemeinsam auf höchstens 4.000 Zeichen gekürzt. So deckt die Stimme genau den Text ab, den Sie mitlesen. Fällt das Modell aus, springt ein Notfall-Skript mit einer Kurzfassung ein.
Die Sprachausgabe übernimmt OpenAI mit der Stimme „marin“; verglichen wurden mehrere Stimmen. Die MP3 liegt auf dem Server und zusätzlich in Google Drive. Passt sie nicht zum Text der Seite, wird sie nicht ausgeliefert.